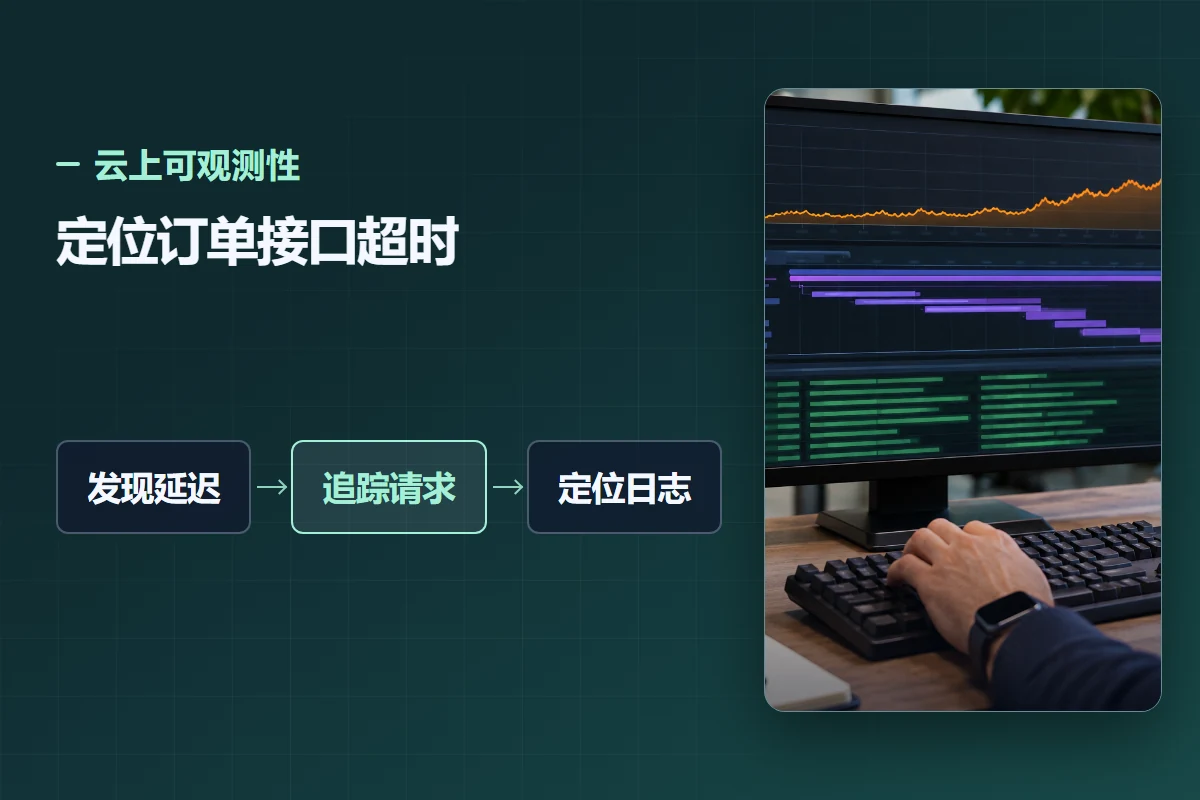
很多团队并不缺监控,缺的是从告警走到原因的路径。CPU 高了、接口慢了、错误率上去了,三条告警同时响起,值班同学却不知道先看哪一条;排查半小时后发现根因是某条慢 SQL 拖垮了连接池。告警数量增加不等于可观测性提升,真正要建设的是“发现异常、判断影响、定位原因、验证恢复”的完整链路。
先统一口径,再谈覆盖
可观测性通常由指标、日志和链路追踪三类数据构成。指标回答“是否异常、异常多大”,日志回答“发生了什么”,链路回答“慢在哪一跳”。三者缺一不可,但建设顺序应从业务目标倒推,而不是先把所有采集 Agent 装一遍。
第一步是确定黄金指标。在线服务至少关注请求量、错误率、延迟分位数和饱和度;批处理任务关注开始时间、执行时长、失败次数和数据产出量;数据库关注连接数、慢查询、复制延迟和磁盘水位;消息队列关注堆积量、消费延迟和死信数量。每个指标都要有明确的统计周期、聚合方式和数据来源,避免同一个“错误率”在监控、日志和报表里出现三个不同数值。
| 信号 | 典型数据源 | 主要用途 | 常见口径问题 |
|---|---|---|---|
| 指标 | 华为云 CES、Prometheus、应用埋点 | 趋势判断、容量规划、告警触发 | 平均延迟掩盖长尾,采集周期与聚合方式不一致 |
| 日志 | 华为云 LTS、应用日志、系统日志 | 错误详情、审计追踪、事件复现 | 缺少请求标识,日志级别混乱,保留周期过短 |
| 链路 | 华为云 APM、OpenTelemetry | 跨服务耗时分析、依赖关系梳理 | 采样率过低,埋点不完整,异步调用断链 |
| 事件 | CTS、发布记录、变更单 | 关联变更与异常,缩短定位时间 | 发布时间与告警时间没有统一时区 |
延迟指标建议同时看 P50、P95 和 P99。平均值容易被大量快请求拉低,P99 才能反映最慢那部分用户的体验。资源指标要结合实例规格看使用率,例如 CPU 使用率高但请求量正常,可能是死循环或异常进程;CPU 不高但延迟上升,可能是锁等待、连接池耗尽或下游依赖变慢。
日志规范要尽早统一。至少包含时间戳、服务名、实例标识、请求标识、用户或租户标识、日志级别、错误码和耗时。请求标识应贯穿网关、应用和下游调用,否则跨服务排查只能靠时间猜测。生产环境避免打印完整身份证号、手机号、令牌和密钥;确需保留时先脱敏。日志保留周期按审计要求和排障需要设定,热日志与归档日志分开管理,控制存储成本。
把告警从“多”改成“准”
告警风暴的根源通常不是阈值太松,而是告警没有分层。建议按影响程度分为四级:P1 是核心业务不可用或资金、数据安全受影响;P2 是核心功能明显降级;P3 是单实例、单节点或非核心功能异常;P4 是趋势预警和容量提醒。不同级别对应不同通知渠道、响应时限和升级路径,P3、P4 不应在凌晨电话叫醒所有人。
每条告警都应有明确的负责人、触发条件、影响说明、处置手册和恢复确认方式。缺少负责人的告警,最终会变成“群里所有人都看到,但没有人处理”。告警内容要包含实例、区域、指标当前值、阈值、持续时间和相关仪表盘入口,减少值班同学在多个控制台之间来回切换。
降低噪声可以从三个动作入手。第一,设置持续时间,例如 CPU 连续 5 分钟超过 80% 才触发,避免瞬时抖动。第二,做聚合和抑制,同一主机上的磁盘、进程、网络告警合并为一个事件,上游故障时抑制下游派生告警。第三,区分症状告警和原因告警,对用户可感知的错误率、延迟设置高优先级,对单机资源指标设置低优先级,避免把“原因”当成人人必须立即响应的“症状”。
好的告警不是让人知道“有东西红了”,而是让人知道“谁受影响、现在该做什么”。
通知渠道也要克制。P1、P2 使用电话加即时消息,P3 使用工单或群消息,P4 进入日报。华为云 CES 可以配置告警规则和通知组,结合 SMN 实现短信、邮件等通知;具体支持渠道和配额以控制台为准。告警恢复通知同样重要,否则值班人员无法判断事件是否结束。
定位体系要能串起来
可定位的核心是关联。一次请求变慢,排查路径通常是:用户侧或拨测发现异常,网关看到错误率上升,APM 显示某个下游服务耗时增加,日志里出现连接超时,最终定位到数据库连接池耗尽或某个依赖接口限流。要让这条路径走得通,请求标识、时间同步、服务拓扑和发布记录必须能互相对应。
建议为关键业务建立统一仪表盘,至少包含入口流量、错误率、P95 延迟、依赖服务健康度、数据库与缓存状态、消息堆积和最近变更。仪表盘不是指标越多越好,而是让值班人员在 30 秒内判断影响范围。可以按“业务视角、应用视角、基础设施视角”分三层,避免把几十个图表堆在一页。
链路追踪要覆盖同步调用、异步消息和定时任务。采样率需要权衡成本与排障需求:全量采集成本高,过低采样又可能错过偶发问题。可以对错误请求和慢请求提高采样率,对正常请求降低采样率。跨服务传递 TraceID 时,注意消息队列、线程池和异步回调场景,否则链路会在最需要的地方断开。
变更关联往往比多看几个指标更有效。发布、扩缩容、参数调整、证书更新、安全策略变更都应记录时间点和操作人。实践中大量“突然变慢”都能追溯到一次配置变更或流量切换。把变更事件叠加到仪表盘上,可以显著缩短定位时间。
常见误区与落地检查
常见误区
- 只装监控工具,不定义业务指标和负责人。
- 所有告警都发到同一个群,没有分级和升级机制。
- 只看平均值,不看 P95、P99 和错误预算。
- 日志没有请求标识,跨服务排查只能靠猜。
- 仪表盘追求大而全,值班时找不到关键结论。
- 只监控服务器,不监控数据库、中间件和外部依赖。
- 告警触发后没有复盘,同样的问题反复发生。
落地检查清单
- 列出核心业务链路,明确每条链路的黄金指标和负责人。
- 统一指标口径、采集周期、聚合方式和时间时区。
- 为应用日志补充请求标识、错误码、耗时和脱敏规则。
- 接入 APM 或 OpenTelemetry,覆盖同步、异步和定时任务。
- 按 P1 至 P4 定义告警级别、通知渠道和升级路径。
- 为高频告警设置持续时间、聚合、抑制和恢复通知。
- 建立业务、应用、基础设施三层仪表盘。
- 把发布、扩缩容和配置变更记录叠加到时间轴。
- 每月复盘告警数量、误报率、平均发现时间和平均恢复时间。
- 每季度做一次故障演练,验证告警、定位和恢复链路。
可观测性建设不是买一套平台就完成,而是把“业务目标、指标口径、告警责任、定位路径、复盘改进”连成闭环。建议从一个核心业务开始,先把入口错误率、P95 延迟、数据库连接数和最近变更四个视图做扎实,再逐步扩展到全站。能减少一次无效告警,往往比新增十个监控面板更有价值。
留言讨论
还没有留言,欢迎留下你想了解的场景。
查看全部留言 ›