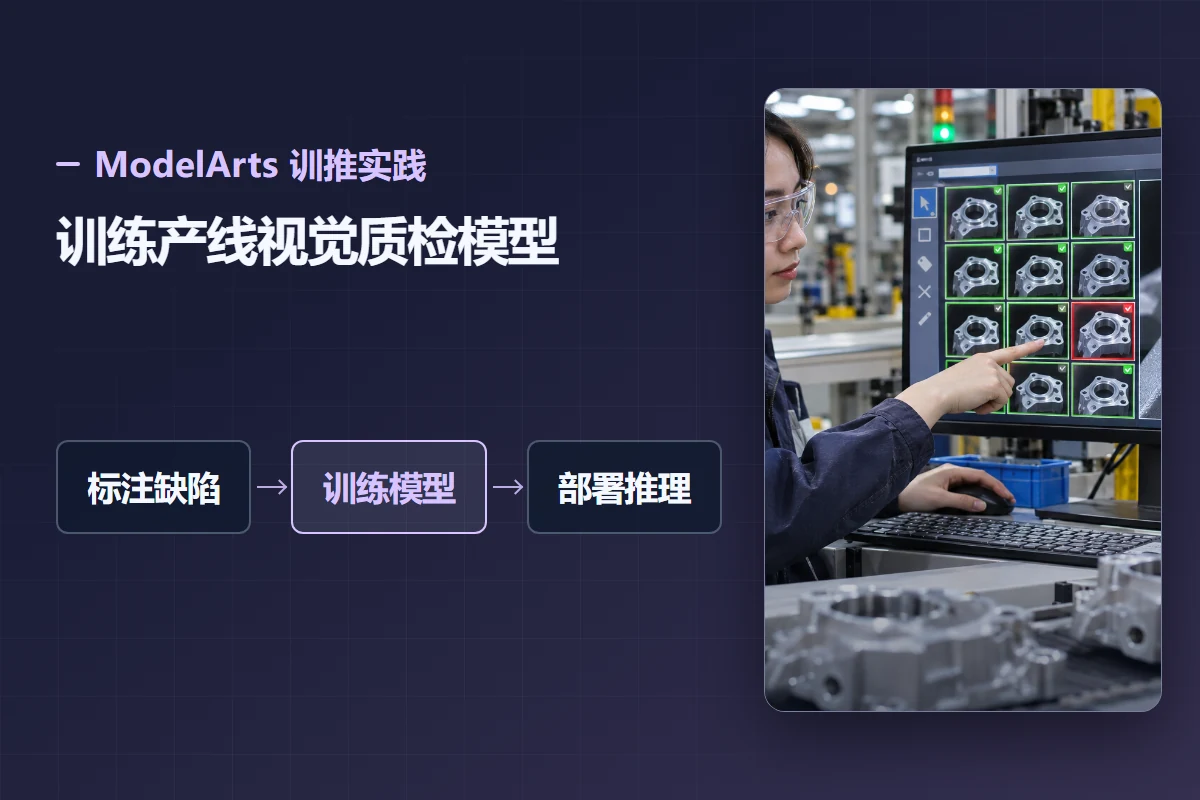
ModelArts 是华为云面向开发者的一站式 AI 开发平台,当前官网名称为“魔坊(ModelArts)模型训推平台”。它围绕数据准备、开发调试、模型训练、模型评估、推理部署和运行管理,提供从算力到工具链的托管能力,帮助团队把 AI 项目从实验验证推进到生产环境。
对初次接触 ModelArts 的团队来说,最容易把注意力放在 GPU 或 NPU 规格上。实际上,一个可落地的 AI 项目还需要数据治理、训练框架、资源调度、模型版本、推理服务和成本控制共同配合。
一、ModelArts 解决什么问题
传统 AI 开发往往需要自行搭建开发机、训练集群、存储挂载、任务调度、模型仓库和推理服务。环境不一致、资源利用率低、训练任务难复现、模型上线链路长,是常见痛点。
ModelArts 将这些环节集中在云平台上:
- 通过数据连接和数据处理工具管理训练数据。
- 提供 Notebook、本地 IDE 插件等方式进行开发调试。
- 使用托管资源运行单机或分布式训练任务。
- 支持模型评估、版本管理和推理服务部署。
- 提供运行监控、日志和资源管理能力。
- 与对象存储 OBS、虚拟私有云 VPC 等云服务协同。
平台降低的是工具链和基础设施的门槛,数据质量、算法选择、业务标注、模型效果和上线后的运营仍由企业团队负责。
二、AI 项目全生命周期
1. 数据准备
数据是模型效果的基础。ModelArts 支持多源数据连接、数据导入、数据处理和管理,并提供面向大模型和多模态数据的标注、合成与增强能力。企业需要先明确数据来源、授权边界、脱敏要求、标注规范和训练/验证/测试集划分。
2. 开发调试
开发者可以使用 Notebook 或本地 IDE 配合 ModelArts 插件进行远程开发,使用平台内置的机器学习框架镜像,减少环境安装和版本冲突。建议把依赖版本、启动命令和随机种子固化,保证实验可以复现。
3. 模型训练
ModelArts 支持大规模分布式训练和多种主流开源框架。训练前应根据模型规模、数据量、单卡显存和通信开销选择资源规格与并行策略。训练过程中要关注吞吐、显存占用、网络通信、检查点保存和失败恢复。
4. 模型评估
模型训练完成不等于可以上线。需要基于独立测试集评估准确率、召回率、延迟、吞吐和资源消耗,并针对业务场景检查偏差、幻觉、安全性和稳定性。多模型对比时,应保证输入条件、评测集和指标口径一致。
5. 推理部署
ModelArts 提供多场景模型推理能力,支持服务与部署解耦、灰度发布、流量镜像、多级流控和故障恢复等机制。生产部署前应明确在线推理、批量推理或边缘部署的差异,并设计容量、超时、重试、降级和回滚方案。
6. 运行与治理
模型上线后仍需持续监控请求量、延迟、错误率、资源利用率和输出质量。模型、数据、提示词和配置都应纳入版本管理,避免出现“线上效果变差但无法定位版本”的问题。
三、ModelArts 的主要能力
数据与标注
面向文本、图像、视频和多模态数据,提供数据连接、处理、标注和管理能力。具体支持的数据类型、算子和标注方式会随平台版本变化。
开发环境
提供在线 Notebook、框架镜像和本地 IDE 远程开发能力,适合算法验证、调试和团队协作。生产任务不应长期依赖个人 Notebook,应将训练和部署流程沉淀为可重复的任务或流水线。
训练与算力
支持多种算力资源和分布式训练,适合从中小模型微调到大规模模型训练的不同阶段。算力规格、可售区域、配额和资源池类型以控制台为准。
推理服务
支持在线推理服务的部署、扩缩容、灰度发布和运行管理。对于大模型,还可关注多实例部署、流式输出、长上下文和推理加速等能力。
模型与工作流管理
围绕模型版本、训练任务、部署服务和运行记录进行管理,帮助团队建立从实验到生产的追踪关系。
四、常见应用场景
| 场景 | 典型任务 | 关注重点 |
|---|---|---|
| 自动驾驶 | 感知、标注、训练、仿真和推理 | 数据规模、标注质量、训练吞吐和车端部署 |
| 金融 | 风控、客服、文档理解、智能投顾辅助 | 合规、可解释性、数据隔离和审计 |
| 医疗 | 报告解读、影像辅助、健康管理 | 数据脱敏、专业标注、模型验证和隐私保护 |
| 政府与公共服务 | 政务问答、文档处理、城市治理 | 数据安全、权限管理、服务稳定性 |
| 矿山与工业 | 视觉质检、设备预测、生产优化 | 边缘部署、实时性、环境适应性和运维 |
| 互联网与内容 | 推荐、搜索、内容生成、审核 | 迭代速度、弹性算力、成本和内容安全 |
五、资源池和算力怎么选
选型时先回答四个问题:训练还是推理、模型多大、数据在哪里、业务对时延和成本的要求是什么。
- 训练任务:关注单卡显存、卡间互联、节点间网络、存储吞吐和任务持续时间。
- 推理任务:关注并发、首 token 延迟、吞吐、上下文长度、扩缩容和峰值流量。
- 数据位置:尽量让算力与 OBS 等数据源处于合适的网络和地域,减少跨区传输。
- 资源池:公共资源与专属资源池在隔离性、成本和可控性上不同,应结合实际业务选择。
- 配额与区域:GPU、NPU 等资源可能受区域和账号配额限制,应提前确认可售规格。
不要只用“单卡价格”比较方案。训练失败重跑、数据搬运、存储、网络、空闲资源和推理冗余都会影响总成本。
六、计费与成本控制
ModelArts 的成本通常与训练和推理资源、资源池类型、运行时长、存储和网络相关。具体计费项、价格和优惠以华为云 ModelArts 计费说明及控制台为准。
成本控制可以从以下方面入手:
- 训练前做小规模验证,避免直接用大规格跑完整数据。
- 使用检查点保存和断点续训,降低任务失败后的重复成本。
- 任务结束及时释放按需资源,避免闲置实例持续计费。
- 根据流量设置推理扩缩容,区分峰谷资源。
- 清理无用镜像、数据集副本和中间文件。
- 为项目设置预算和告警,定期复盘资源利用率。
七、从试点到生产的实施路径
- 场景选择:优先选择数据基础较好、价值明确、风险可控的场景。
- 数据治理:完成数据盘点、授权、脱敏、标注规范和评测集建设。
- 小规模验证:用较小模型和样本验证可行性,明确指标与验收口径。
- 训练与评估:固化环境、参数和版本,进行离线评测和对比。
- 推理上线:设计服务容量、灰度、监控、回滚和降级方案。
- 持续运营:收集线上反馈,监控效果与成本,形成数据闭环。
八、常见误区
- 只关注算力价格,不评估数据质量和标注成本。
- 没有独立测试集,用训练集效果判断模型好坏。
- 实验环境可以运行,但没有固化依赖和启动方式,无法复现。
- 训练任务没有检查点,失败后只能从头开始。
- 模型直接全量上线,没有灰度、回滚和限流。
- 只监控服务器指标,不监控模型输出质量和业务效果。
- 把通用大模型直接用于高风险业务,却没有人工复核和合规评估。
常见问题
ModelArts 适合哪些人使用?
适合算法工程师、数据科学家、AI 平台团队以及需要构建模型训练和推理能力的企业研发团队。没有算法经验的业务人员可以先从成熟的模型服务或行业方案入手。
ModelArts 和 MaaS 有什么区别?
ModelArts 更偏向模型开发、训练和部署平台,提供较完整的 AI 工程工具链;MaaS 模型即服务更偏向直接调用托管模型能力。实际项目中两者可以组合使用,具体边界以华为云当期产品说明为准。
ModelArts 是否只能用于大模型?
不是。它同样适用于传统机器学习、计算机视觉、自然语言处理、推荐和预测等任务。大模型训练与推理只是其中一类重要场景。
使用 ModelArts 是否还需要 OBS?
训练数据、模型文件和中间产物通常需要对象存储承载,OBS 是常见的配套服务。具体存储方案应结合数据量、访问频率、权限和成本设计。
参考资料
如果你正在规划 AI 训练、模型推理或行业智能化方案,可以查看站点内的 对象存储 OBS、弹性云服务器 ECS 与 虚拟私有云 VPC,也可以联系云起时空顾问获取场景评估建议。邮箱:maasunion@yunqitime.com。公司地址:四川省成都市成华区双店路66号1栋1单元5层512号。
留言讨论
还没有留言,欢迎留下你想了解的场景。
查看全部留言 ›